消费者投诉意见挖掘系统
Reading follows project access rules; attachments and credentials cannot currently be downloaded.
功能介绍
消费者投诉意见挖掘系统面向消费研究、企业客服分析和文本挖掘学习场景,将投诉数据采集、统计探索、中文预处理、词云展示与 LDA 主题分析串成分阶段流程。使用者先按采集脚本获取公开投诉记录,以投诉编号去重,整理标题、摘要、品牌、原因、状态和来源等字段,再构建用于分析的主文本。
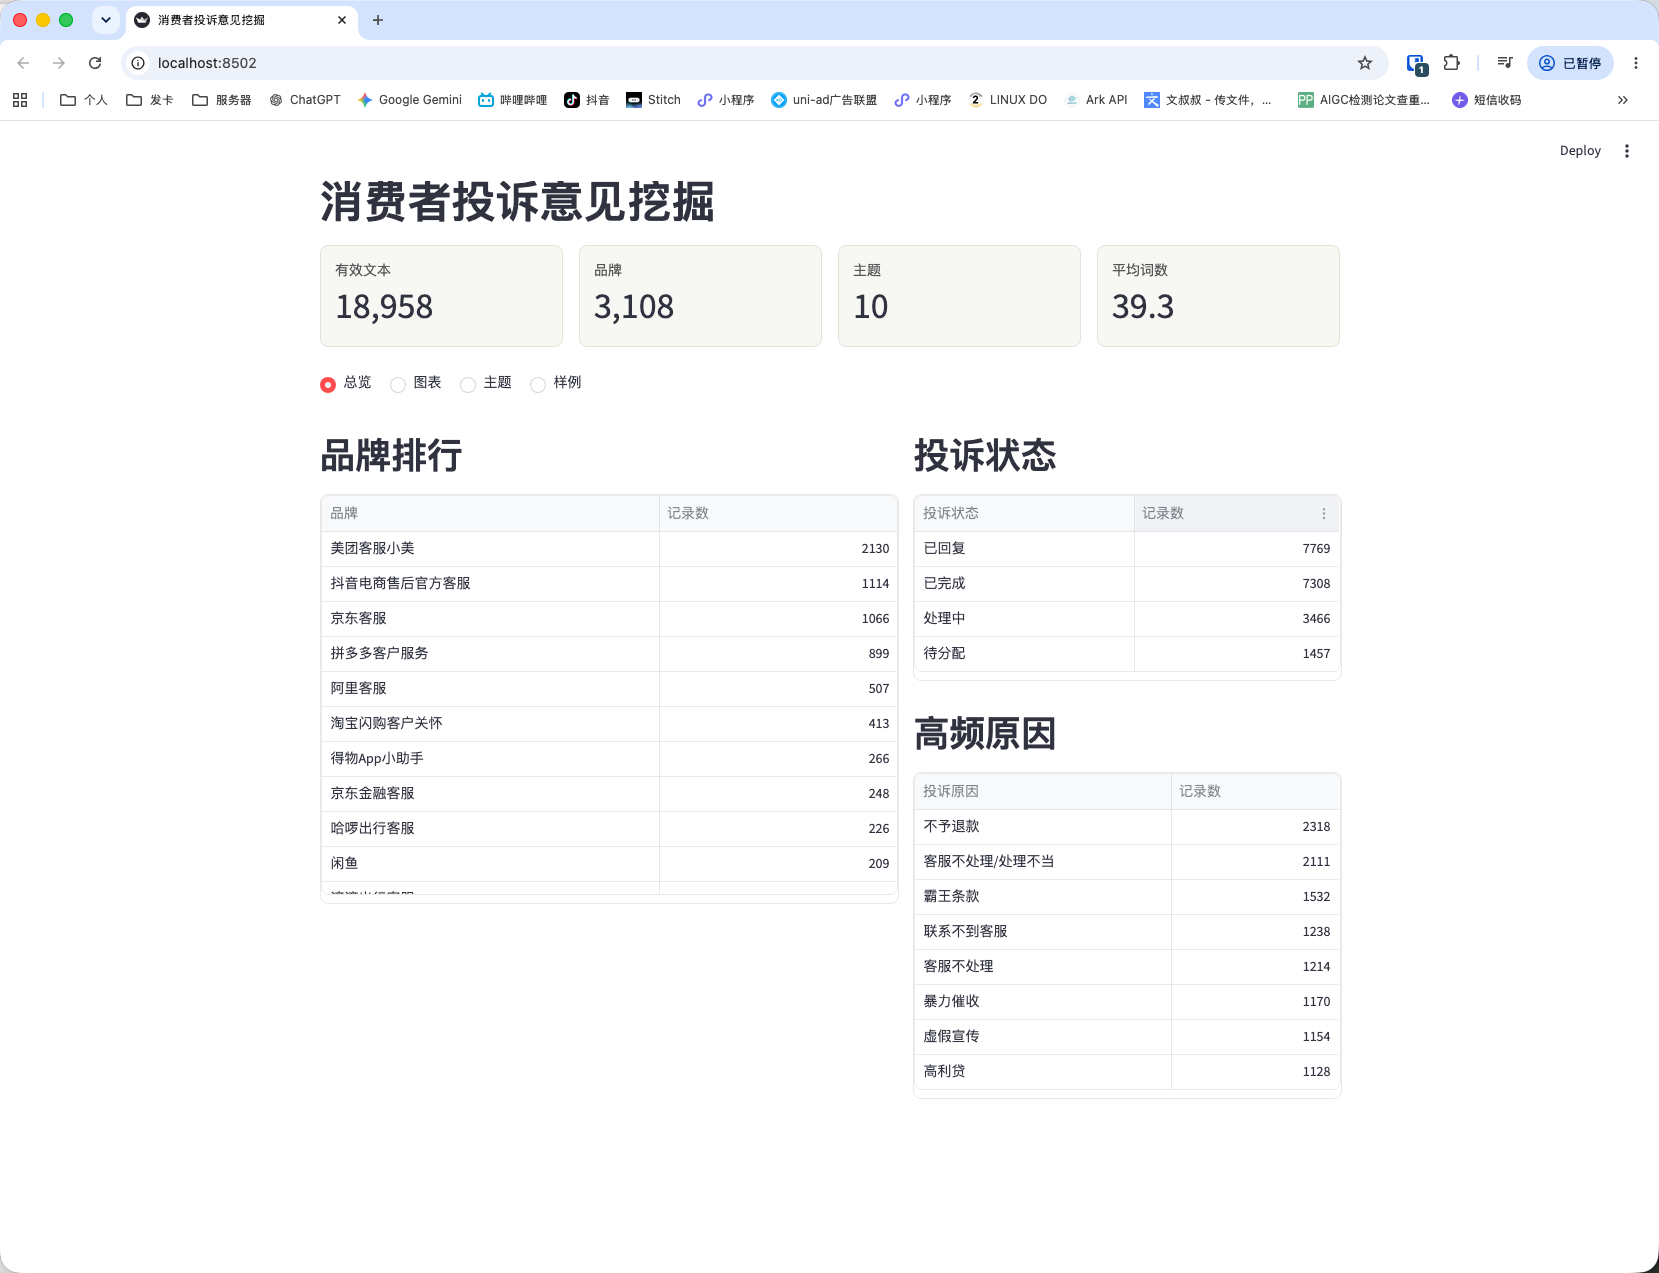
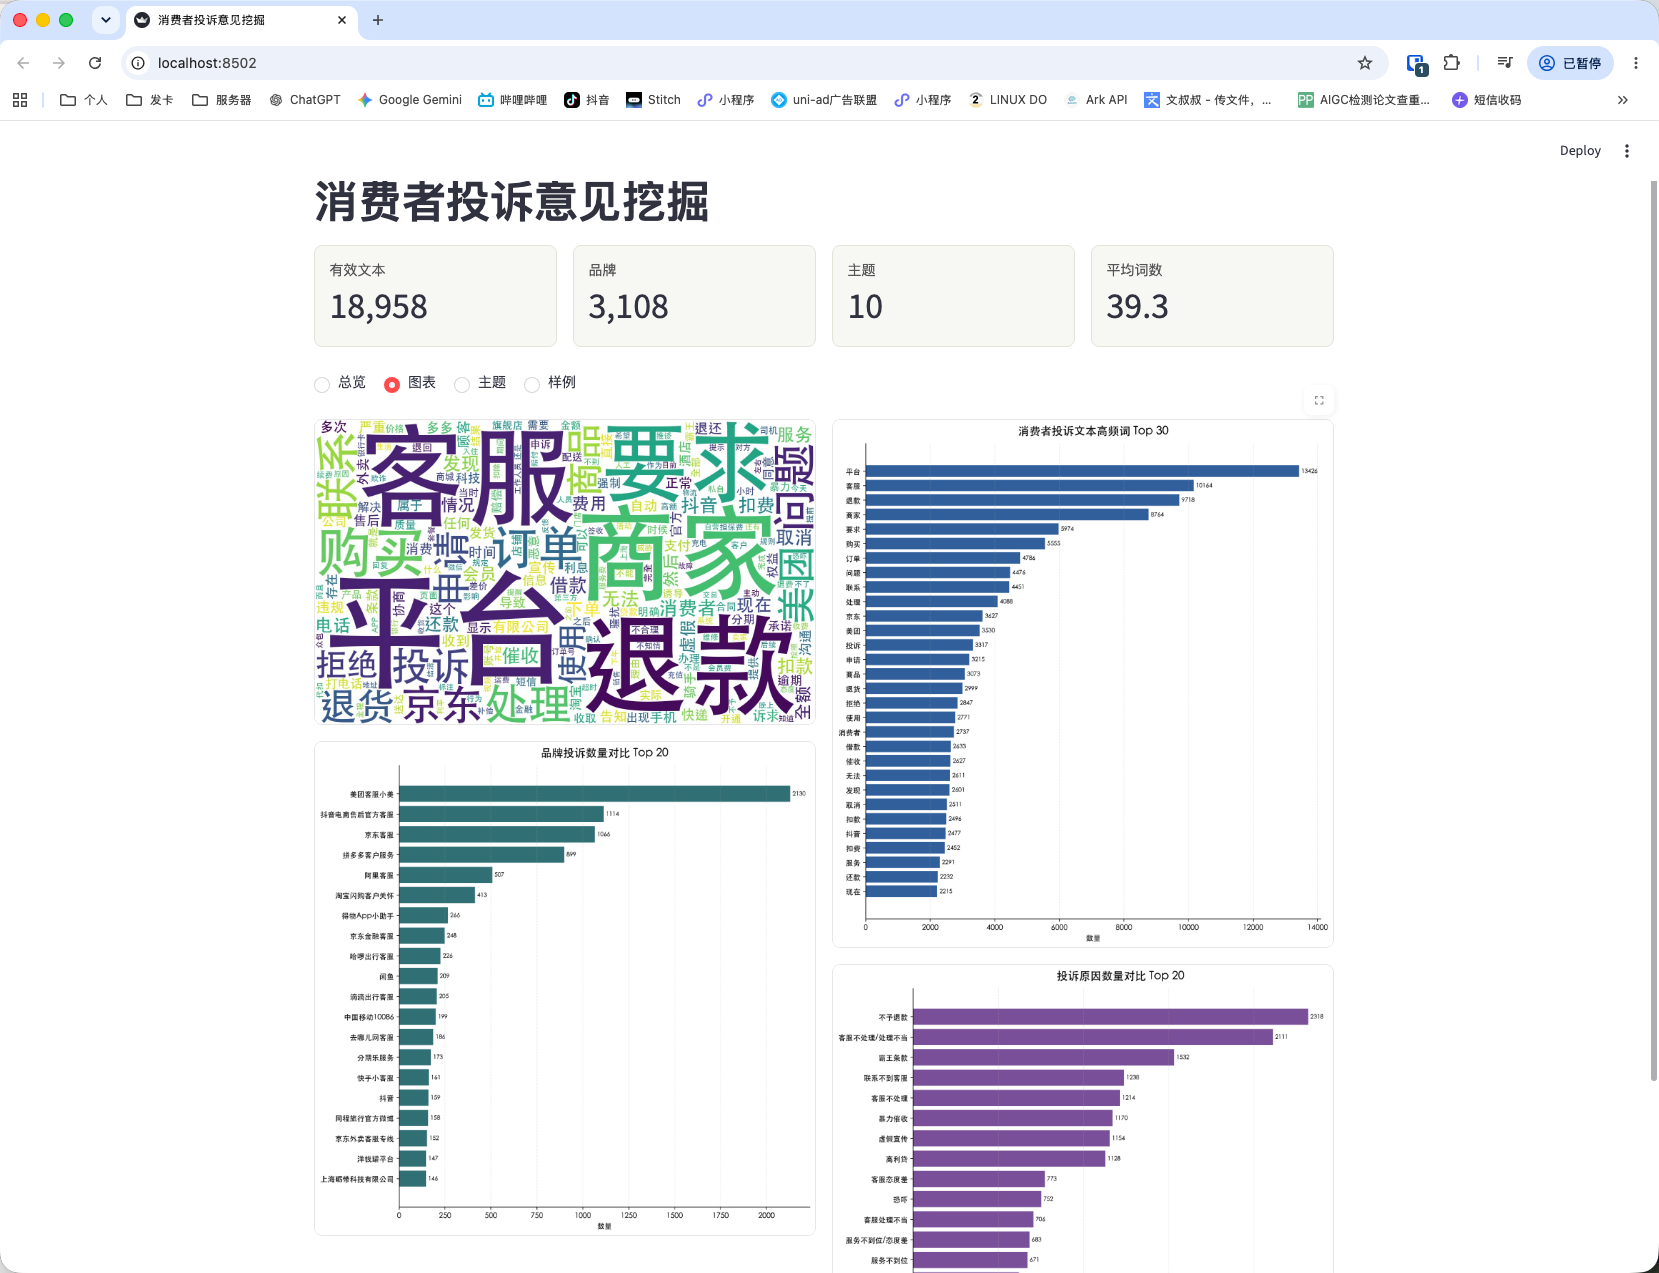
数据探索阶段统计品牌、投诉原因、状态和行业分布;文本预处理去除 URL、无效空白及重复文本,使用 jieba 分词并过滤停用词,得到词频与分词语料。可视化阶段生成整体词云、高频词、品牌对比和原因对比图,帮助观察消费者集中反馈的问题。
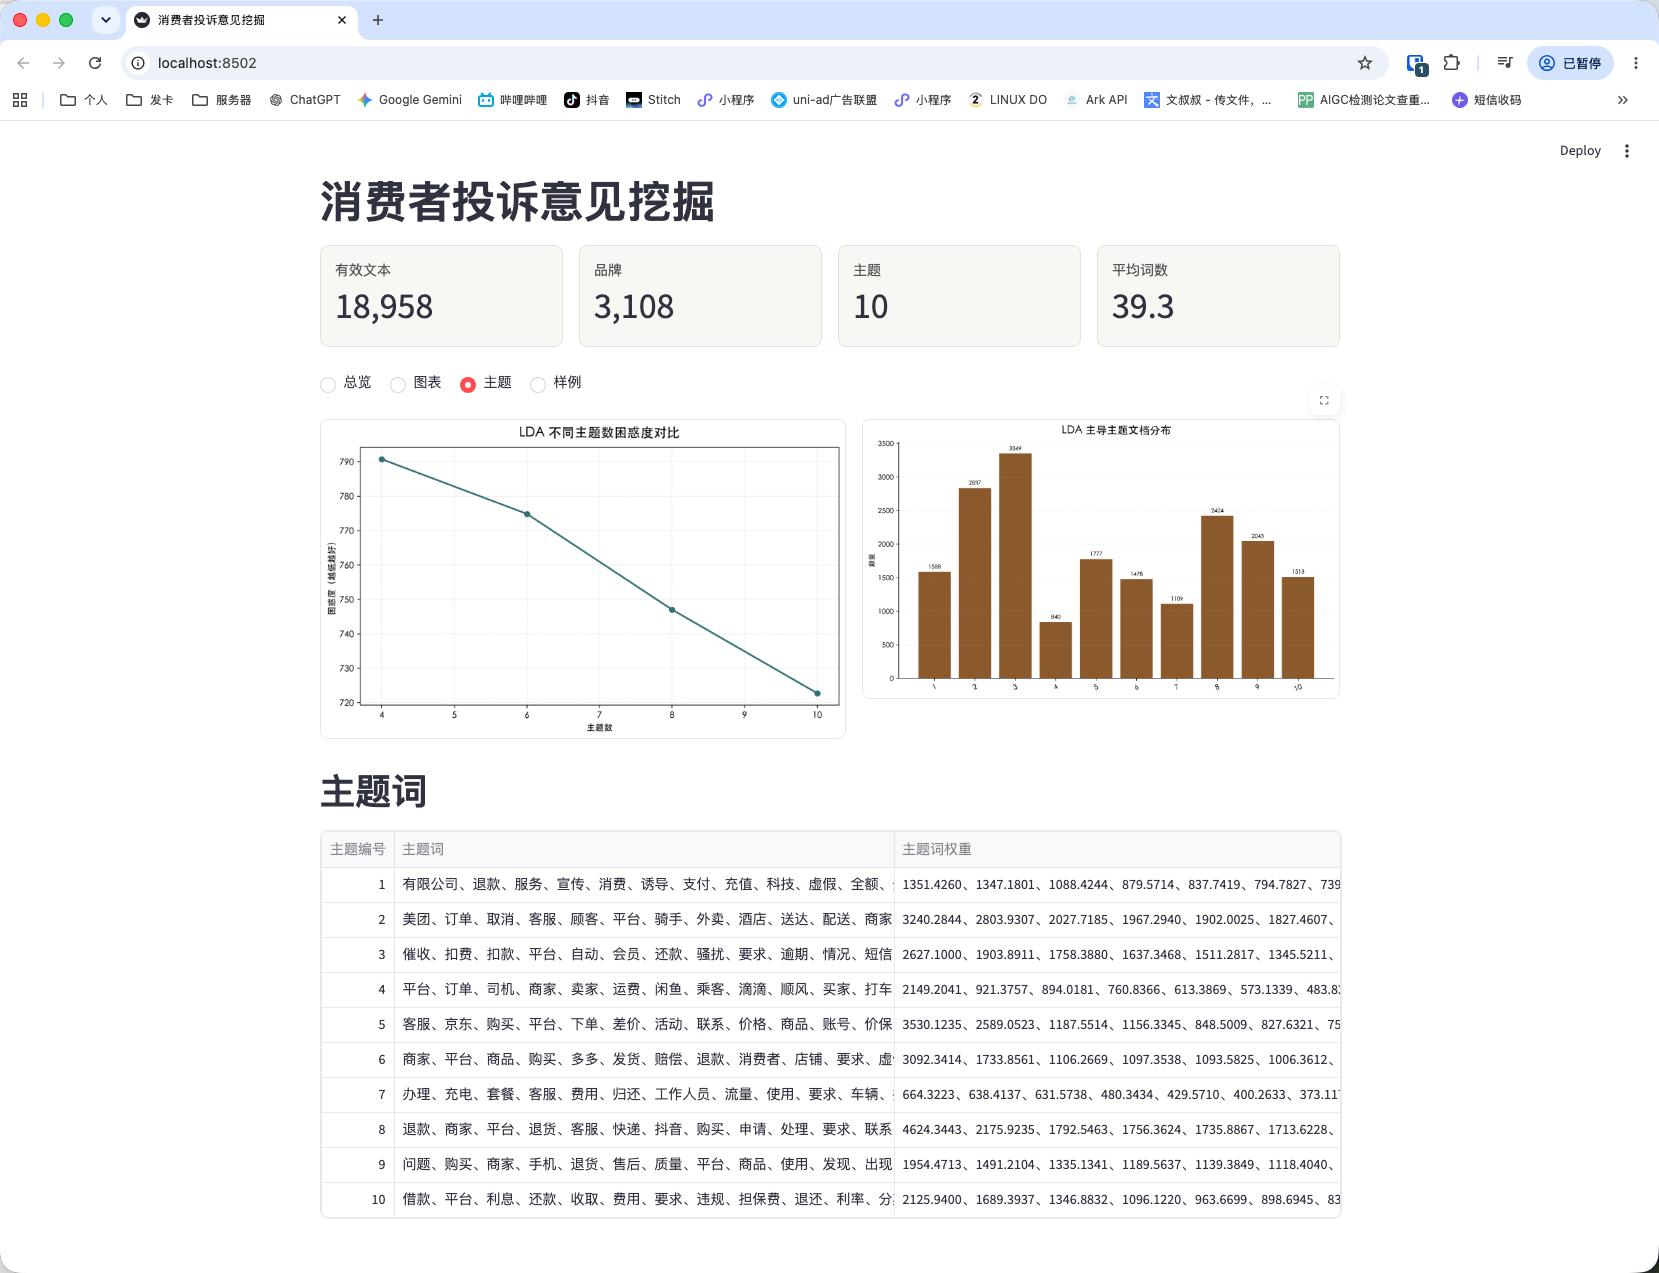
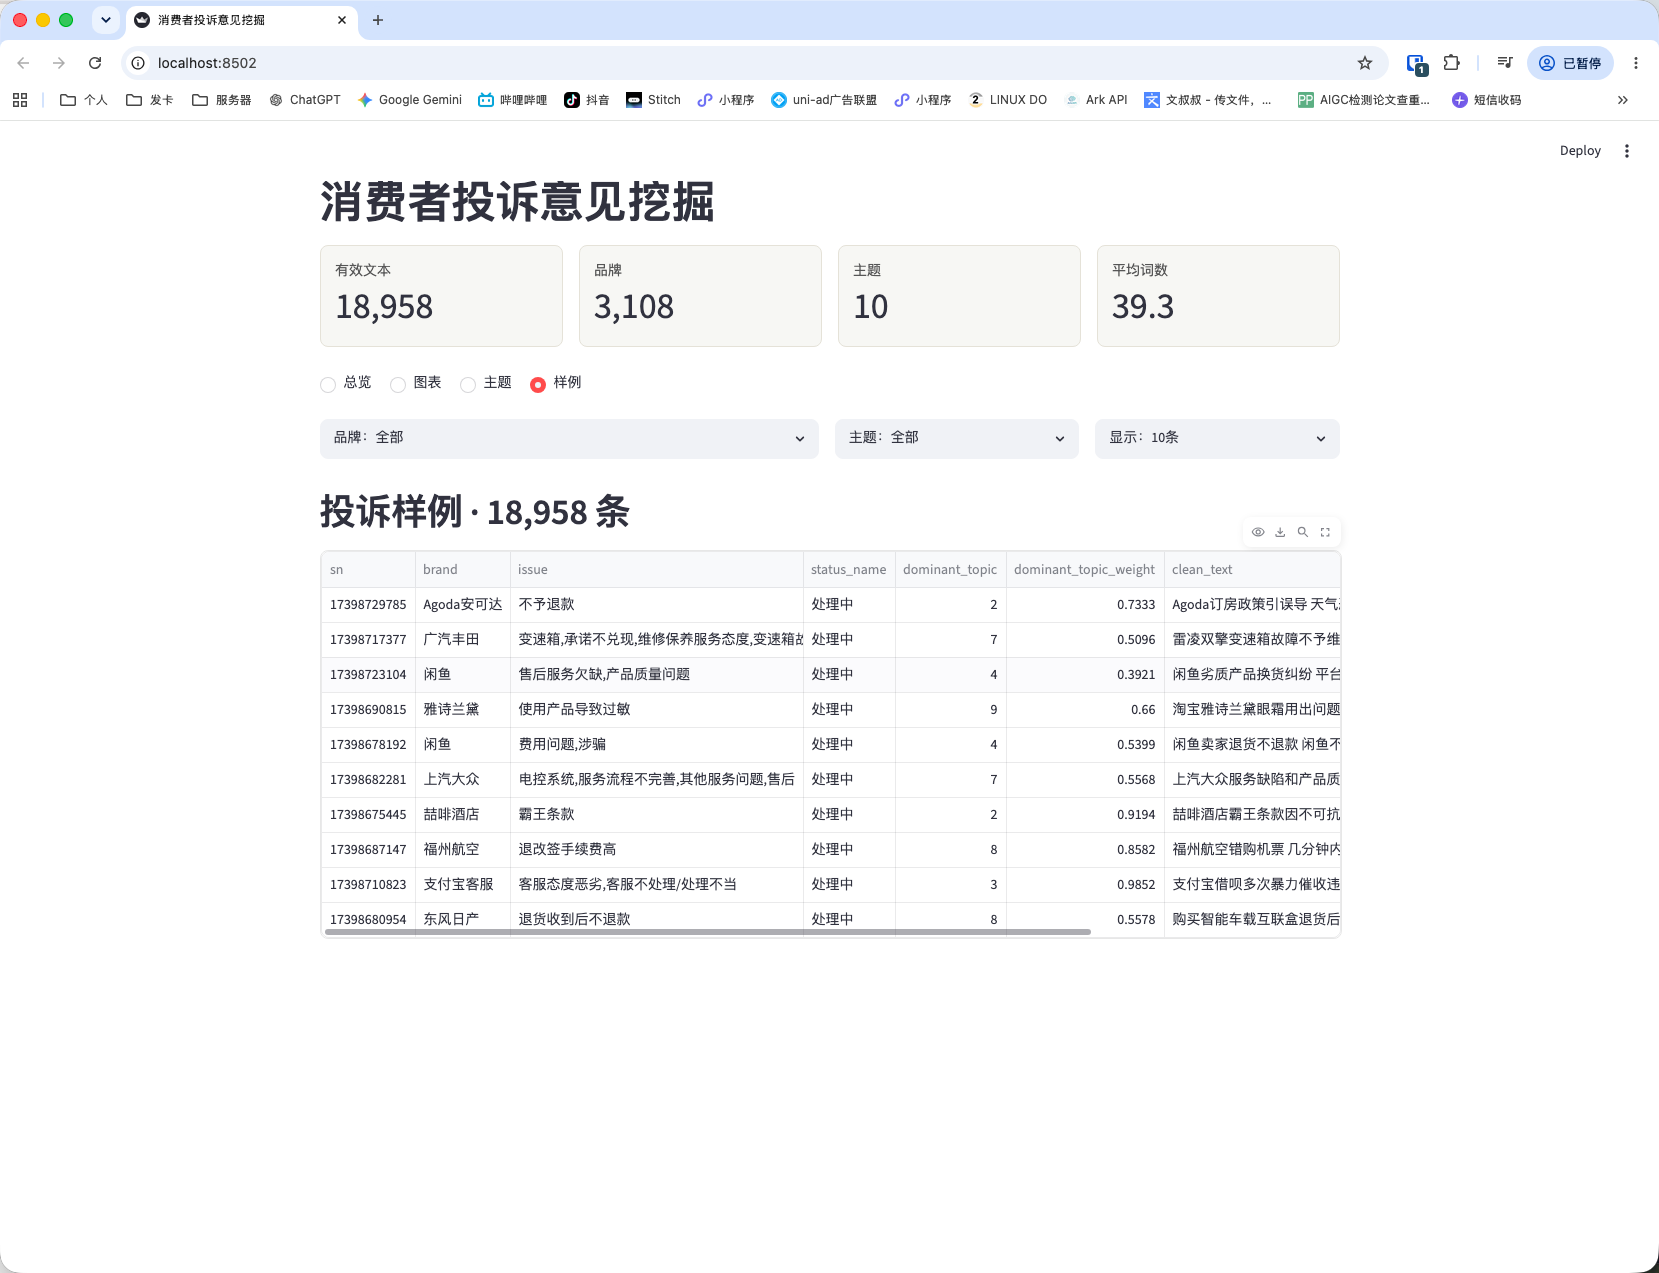
模型阶段使用 LDA 挖掘投诉主题,比较不同主题数的困惑度,输出主题词和每条投诉的主导主题。Streamlit 页面读取已生成分析结果,集中展示数据概览、图表、LDA 主题和投诉样例,使用者可按品牌与主题筛选文本。典型场景是从某品牌投诉量入手,查看相关主题词,再定位样例投诉解释具体问题。
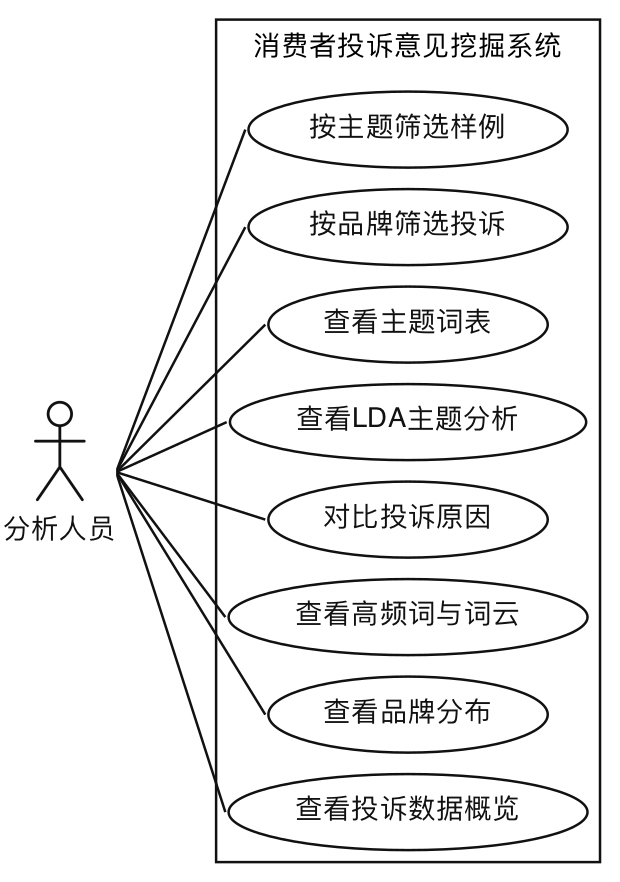
用例图/使用场景
数据准备 → 投诉记录去重 → 统计探索 → 清洗与分词 → 词云及分布图 → LDA 主题建模 → 在 Web 页面按品牌、主题筛选投诉样例。现有用例图展示分析使用者的操作范围。
演示截图
技术栈
采用 Python、Pandas、jieba、Scikit-learn、Streamlit、Matplotlib、WordCloud、Pillow 与 Joblib。工程按数据获取、探索、预处理、可视化、模型构建与 Web 展示分目录组织;页面读取已有分析结果,模型训练由独立脚本完成。附件排除环境依赖与较大的原始数据文件,保留源码、准备流程、分析资料、用例图和演示截图。
项目资料附件
- Python+爬虫+Ai+Streamlit-消费者投诉意见挖掘系统-实验报告.zip
- Python+爬虫+Ai+Streamlit-消费者投诉意见挖掘系统-截图.zip
- Python+爬虫+Ai+Streamlit-消费者投诉意见挖掘系统-源码-001.zip
- Python+爬虫+Ai+Streamlit-消费者投诉意见挖掘系统-源码-002.zip
- Python+爬虫+Ai+Streamlit-消费者投诉意见挖掘系统-源码-003.zip
- Python+爬虫+Ai+Streamlit-消费者投诉意见挖掘系统-源码-004.zip
- Python+爬虫+Ai+Streamlit-消费者投诉意见挖掘系统-源码-005.zip
- Python+爬虫+Ai+Streamlit-消费者投诉意见挖掘系统-源码-006.zip
- Python+爬虫+Ai+Streamlit-消费者投诉意见挖掘系统-源码-007.zip
- Python+爬虫+Ai+Streamlit-消费者投诉意见挖掘系统-演示视频.zip
- Python+爬虫+Ai+Streamlit-消费者投诉意见挖掘系统-答辩ppt.zip
- Python+爬虫+Ai+Streamlit-消费者投诉意见挖掘系统-答辩辅助pdf.zip
定制服务:+v pink996611